「レポートでは競合が上位なのに、私がChatGPTに聞いたら弊社が1位でした」。LLMO(AI検索で推奨されるための対策)の計測を始めた会社から、必ず出る食い違いです。
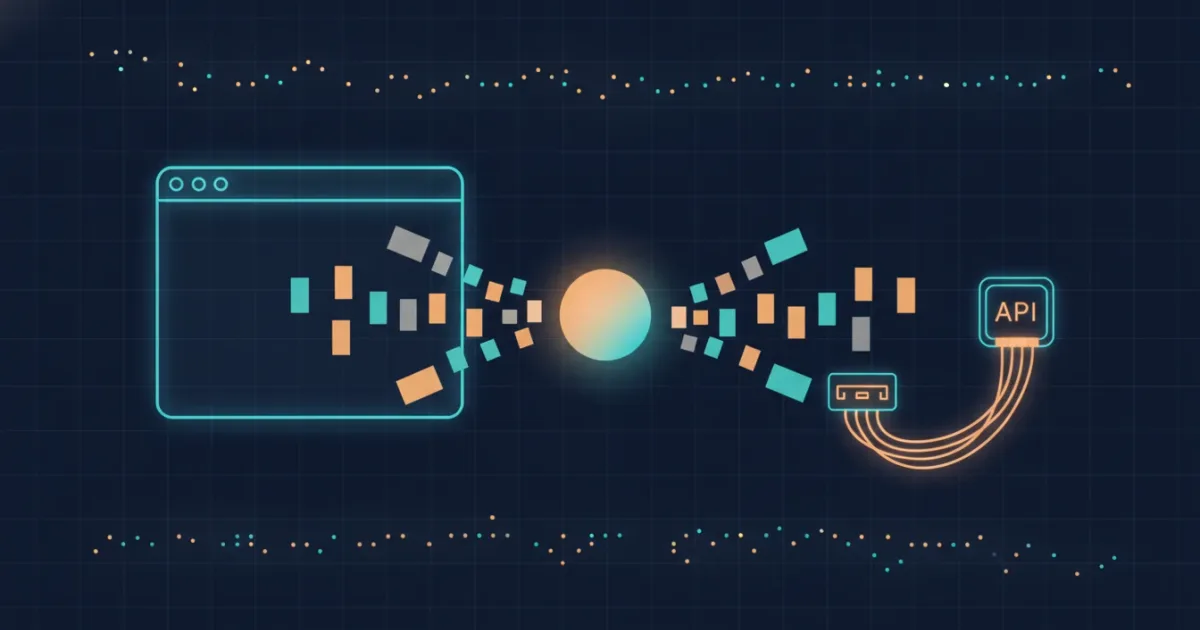
AI可視性計測の「ブラウザ方式」は、ChatGPTなどのブラウザ版を自動操作して質問し、表示された回答と出典を集める方式です。「API方式」は開発者向けの接続口(API)から同じ系統のモデルに質問し、返ってきた回答と引用を集める方式です。どちらも計測会社の環境で質問しており、実際のユーザー操作を観察しているわけではありません。
この2つのどちらが「本物」か。業界には答えが決まっているかのような一文が並びます。
「APIの応答は、スクレイピングした応答と非常に強く異なる。AI可視性の代理指標としてAPIの応答を監視するのは、完全に間違っている」(Wojciech Korczyński氏/Surfer・当社訳)
本当かどうか、順に確かめました。
みんなブラウザで使っている。だから「ブラウザで測るのが本物」
出発点は、ブラウザ勢と当社が共有する事実です。ユーザーはChatGPTやGeminiをブラウザかアプリで使い、APIから質問する人はいません。ここに異論はありません。
業界の主流は、ここからこう続けます。「ユーザーが使っているそのブラウザを測れば、ユーザーが見る答えが手に入る。だからブラウザで測るのが本物で、APIは違う」。
| 社 | 記述(各社公式・当社訳) |
|---|---|
| Profound | 「他社はAPIからAI応答を取る。当社はブラウザから直接取る。Profoundで見えるものが、顧客がAIに聞いたときに見るものだ」「APIは実ユーザーが見るものと違う結果を返す」。数値根拠は示されていない |
| Promptwatch | 「何億人もの人が毎日使うLLMのUIをスクレイピングして収集」「APIではなく、ユーザーインターフェースからの実クロールデータ」。数値根拠は示されていない |
| Otterly | 「AI検索のサイト(chatgpt.com等)にプログラムで質問を投稿」「APIベースのデータは限定的だったり、フィルタされたり、実際にユーザーが見るものと違う構造でありうる」 |
| Surfer | 1,000回の実行で比較。出典の重なり4%、ブランドの重なり24%。APIは23%が検索しない |
共通点がひとつあります。すべて、その方式を売っている会社自身の記事です。根拠は独立に確かめる必要があります。
この理屈が成り立つには、2つのことが必要です
「ユーザーはブラウザにいる」から「計測会社のブラウザが本物」へ進むには、口に出されていない前提が2つ要ります。
- ブラウザで測れば、同じ答えが再現できること(1回の計測がブラウザの答えを代表する)
- 計測会社のブラウザが、ユーザーのブラウザと同じ環境であること
どちらかが崩れれば、理屈は成り立ちません。ひとつずつ確かめます。
ブラウザに翌日もう一度聞くと、出典は4割しか一致しない
ブラウザ方式の計測ツール(Promptwatch。モニター設定は国=日本、言語=日本語、ペルソナなし)で2026年8月20日から9月5日まで毎日集めた12問(一般知識・商品推薦・最新情報・公共制度)の回答を使い、同じ質問への「その日の回答」と「翌日の回答」で、引用した出典サイトの顔ぶれがどれだけ一致するかを測りました。一致度は、両日の出典を合わせた名簿のうち共通するものの割合です(Jaccard係数。1なら完全一致、0なら総入れ替え)。
| AI(ブラウザ) | 翌日の一致度 | ペア数 | 引用数/回 |
|---|---|---|---|
| ChatGPT | 0.40 | 172 | 3.2件 |
| Google AI Overviews | 0.44 | 59 | 5.2件 |
| Google AIモード | 0.34 | 61 | 8.4件 |
| Gemini | 0.36 | 147 | 3.7件 |
| Microsoft Copilot | 0.46 | 184 | 4.3件 |
| Perplexity | 0.68 | 186 | 9.1件 |
ChatGPTでは出典のうち共通するのは4割です。質問別では0.12から0.92まで開きがあり、「子どもの発熱で病院に行く目安は?」が0.92、「直近の日銀の政策金利はどうなっている?」が0.72、「中小企業向けの会計ソフトのおすすめは?」が0.64と高い一方、「最近発表されたスマートフォンの新機種を教えて」は0.13、「通勤用のビジネスリュックでおすすめは?」は0.12でした。商品や新製品を推薦させる質問ほど、翌日には別の出典に入れ替わります。
海外の学術研究も同じ性質を報告しています。Schulteら(2026)はChatGPTなど4つのAI検索にブラウザ経由で同じ質問を24時間以内に最大10回投げ、ChatGPTでは出典ドメインの一致度が0.233、ブランド名の一致度が0.437だったと記録しています。データはすべてブラウザからのスクレイピングです。
Profound自身の研究も同じ方向です。同社は2025年6月と7月に同じ約8万プロンプトを各AIで実行し、7月の引用ドメインのうち6月には無かったものの割合を、ChatGPTで54.1%、Google AI Overviewsで59.3%と報告しました。同社の総括は「40〜60%のドリフトは、単発のデータポイントを無意味にする」(当社訳)です。
ブラウザで1回測った答えは、翌日のブラウザの答えすら代表しません。「1回測れば本物」という1つ目の前提は、ここで崩れます。崩れるのは方式そのものではなく、単発の答えを代表値として扱う前提です。反復して分布として集計するなら、ブラウザ方式でも読めます。
計測会社のブラウザは、あなたのブラウザではない
次に、計測会社のブラウザがユーザーのブラウザと同じ環境かどうかです。
ChatGPTの回答は、ログインしたユーザーごとに個人化されます。OpenAIは2025年4月10日にメモリ機能を拡張し、明示的に保存した記憶(saved memories)に加え、過去のチャット履歴(chat history)を参照する方式を加えました。公式ヘルプには「メモリはチャット・ファイル・接続アプリから有用な文脈を自動的に記憶し、体験を個人化する」とあり、一時チャットは「既存のメモリを使わず、新しいメモリも作らない」と明記されています(いずれも当社訳)。メモリが有効なユーザーが見る回答は、その人の履歴が反映された回答です。
一方、計測会社の自動ブラウザは、個人の履歴を持たない状態で質問するのが通例です。Otterlyは「メモリ・位置情報・検索履歴によるパーソナライズの偏りを避ける」と公式サイトに掲げ、国内のawoo GEO Suiteは「シークレットモードに近い環境で実施」と開示しています。この2社は、個人の履歴の影響を避ける設計だと確認できます。Profound・Promptwatch・Otterlyは、当社が確認した範囲では、計測ブラウザが無料版か有料版か、ログインしているか、どの版のモデルかを公開していません(2026年8月29日および9月4日確認)。
冒頭の食い違いの原因の一つがここにあります。担当者のブラウザは、メモリが有効ならその人向けに個人化された答えを返します。質問文の違い、ティアや版の違い、生成時の揺れでも同じ食い違いは起きます。計測会社のブラウザは、個人の履歴を持たない答えを返しています。この記事で扱う計測環境は3種類あり、それぞれ測っているものが違います。
| 環境 | メモリ・履歴 | 条件の固定 | 測っているもの |
|---|---|---|---|
| 個人のブラウザ(ログイン) | 設定による(既定は有効。一時チャットや無効化では使わない) | できない | その人向けの答え |
| 計測会社のブラウザ | 履歴なしが通例(Otterly・awooは明記。ティア・ログイン状態は多くが非開示) | できない(非開示) | 新規ユーザーの答え(条件不明) |
| API | なし | できる(版・位置情報・検索・回数を明示) | 指定した条件の答え |
環境の設定が結果を動かすことは、当社の実測でも確認できます。Geminiは無料相当(gemini-3.5-flash)と有料相当(gemini-3.1-pro-preview)のAPIで、Web検索で外部の出典が付いた割合が92%と44%に割れました(ティアだけでなくモデルも異なる2つの構成です)。ChatGPTのAPIに「利用者は日本にいる」と1行指定した構成では、ブラウザ版との出典一致が0.29から0.44に動きました(2026年8月13日のパイロット。質問数・反復・区間推定は取っておらず、生成時の揺れとの分離はできていないため、効果としては未確認の参考値です)。質問文を「LLMO対策ができる会社は」から「中小企業におすすめのLLMO対策会社は」に変えると、7回連続で同じだった第一推奨が4社に割れました(2026年8月24日・2問×各7回の単発比較で、質問文の効果と生成時の揺れは分離できていません。参考例です)。
ログインなしのブラウザの回答は、誰の体験でもない基準点です。基準点として意味はありますが、それを「実ユーザーの体験」と呼ぶのは誤りです。2つ目の前提も崩れます。
「ブラウザで測れば本物」とは、言えない
前提が2つとも崩れたので、「ユーザーはブラウザにいる。だから計測会社のブラウザが本物」という理屈は成り立ちません。
裏づけがもうひとつあります。「APIは完全に間違い」と言ったのはSurferのKorczyński氏ですが、ブラウザ方式を掲げる計測会社の側でも、一部はAPIを使っています。Otterlyは公式ヘルプにこう明記しています。
"please note that we only use API for Claude tracking." (ご注意ください。Claudeの追跡にはAPIのみを使用しています)
Promptwatchも同じです。公式解説には「APIモデルは意図的にプロバイダーのAPIから呼び出す」「Claudeやコーディングアシスタントなど一部のAPIモデルは、Web検索ツールを付けて実行する」とあります(当社訳)。ブラウザで取っているのはChatGPTなど一部で、Claudeはどちらの会社でもAPIです。ログインが必須でスクレイピングが難しいAIでは、主義よりも実務が優先されています。
例外はProfoundです。同社は取得対象としてChatGPT・Perplexity・Claude・Copilot・Google AI Overviews・AIモード・Gemini・Grok・DeepSeekの9つのサービスを挙げ、「APIの呼び出しではなく、フロントエンドのユーザー体験に焦点を当てる」(当社訳)と明記しています。Claudeまでブラウザで貫くにはそれだけの装置が要ります。
では、ブラウザとAPIで答えは違うのか
「ブラウザで測れば本物」が成り立たないとしても、ブラウザ勢にはもうひとつの主張があります。「ブラウザとAPIでは、返ってくる答えが違う」。Promptwatchは「完全に挙動が違う」、Surferは「出典の重なりは4%」、Profoundは「APIは実ユーザーが見るものと違う結果を返す」と書いています。
当社は、この差を自分で測り、同じブラウザに翌日もう一度聞いたときの差と並べました。本当に違うなら、どちらで測るかは選ぶ理由になります。別物なら一致度は翌日の聞き直しより低く、同程度なら方式のせいとは言えません。
2026年8月17日から9月5日まで、同じ12問を毎日、ブラウザ(Promptwatch・8月20日から)とAPI(当社AI Pulse)で取得し、質問×日付×モデルで突き合わせました。ChatGPTで突合できたのは199ペアです。APIのモデルは無料相当がgpt-5.6-luna、有料相当がgpt-5.6-solで、いずれもWeb検索ツールを有効にしています。
| ChatGPT | ブラウザ | API(無料相当) |
|---|---|---|
| 外部の出典が付いた割合 | 97% | 93%(有料相当も93%) |
| 引用された出典の数(出典あり回の平均) | 平均3.2件 | 平均2.3件(有料相当2.7件) |
同じ日のブラウザとAPIの出典の一致度は0.40でした(両側に出典があった185ペア。有料相当も0.40)。
質問の種類別に見ても、外部の出典が付く割合は同じ形でした(ChatGPTのブラウザ対API無料相当で、一般知識98%対95%、商品推薦100%対100%、最新情報100%対100%、公共制度90%対75%)。API側で検索クエリの記録が残った割合も92%(有料相当93%)で、出典の付き方と一致します。「APIは検索しない」は、この実測では支持されません。
残る違いは「出典の顔ぶれが0.40しか重ならない」です。同じ方法で聞き直したときの一致度と並べます。
| AI | ブラウザ対API(同日) | ブラウザに翌日もう一度 | APIに翌日もう一度 |
|---|---|---|---|
| ChatGPT | 0.40 | 0.40 | 0.65(無料相当)/0.69(有料相当) |
| Google AI Overviews | 0.56 | 0.44 | 0.45 |
| Google AIモード | 0.38 | 0.34 | 0.37 |
| Gemini | 0.10/0.06 | 0.36 | 0.37/0.32 |
| Perplexity | 0.29 | 0.68 | 0.72/0.70 |
Jaccard係数は、両側の出典の件数が違うと1になりません。ChatGPTはブラウザが平均3.2件、APIが2.3件なので、同日のブラウザ対APIの上限は0.72です。件数の差を補正するため、共通する出典を小さい方の件数で割ったoverlap係数も併記します(Jaccardと同じペアで算出)。
| モデル(overlap係数) | 同日のブラウザ対API | 同じブラウザに翌日 | 同じAPIに翌日 |
|---|---|---|---|
| ChatGPT | 0.63(無料相当)/0.64(有料相当) | 0.62 | 0.82/0.85 |
| Google AI Overviews | 0.80 | 0.69 | 0.69 |
| Google AIモード | 0.61 | 0.55 | 0.67 |
| Gemini | 0.31/0.15 | 0.62 | 0.61/0.54 |
| Perplexity | 0.61/0.60 | 0.77 | 0.87/0.86 |
補正しても、ChatGPTでは同日のブラウザ対API(0.63)と同じブラウザの翌日(0.62)はほぼ同じ値です。Geminiの低さも残ります。
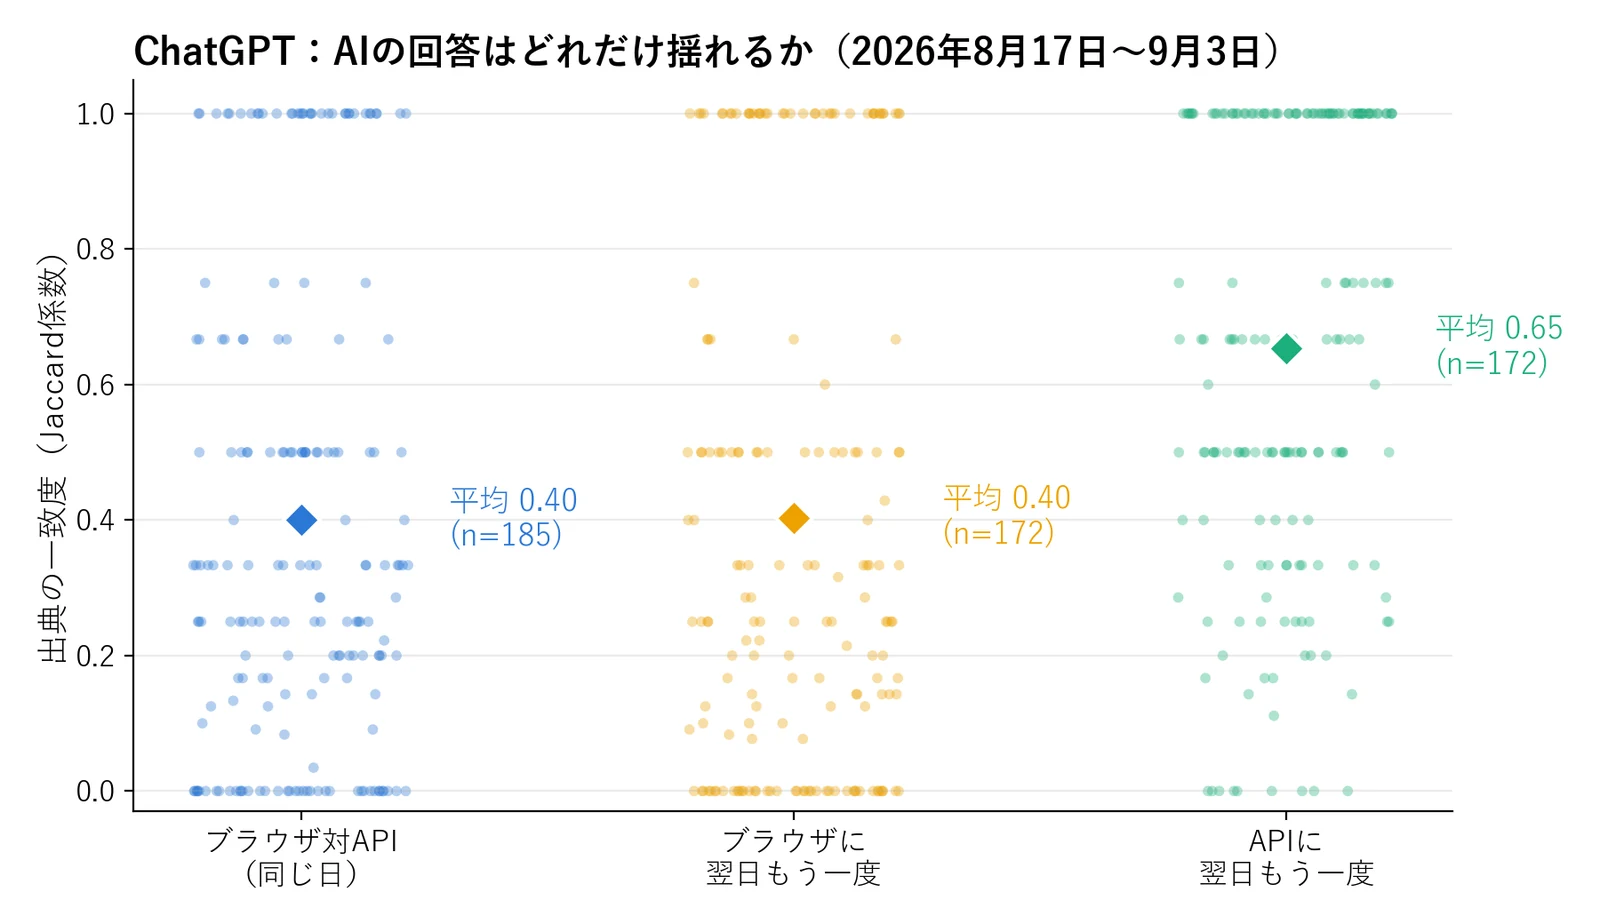
ChatGPTでは、ブラウザとAPIの出典の一致度は当社の実測で0.40でした。同じブラウザに翌日もう一度聞いたときの一致度も0.40で、差は−0.003です。
連続する日のペアは同じ回答を共有するので、質問を単位にしたブートストラップ(5,000回)で差の95%区間を出すと、−0.11から+0.07でゼロを含みます。「差があるとは言えない」という意味であり、同じ値だと証明したわけではありません。
片側だけに出典があった回を不一致(0)として含めても0.38対0.38(有料相当も0.38対0.38)。15日分(149ペア)で0.41対0.39、17日分(172ペア)で0.40対0.40と、関係は変わりませんでした。ここで比べているのは出典の顔ぶれです。ブランドと第一推奨は後の節で別に測ります。
Google AI Overviewsでは、同じ日のブラウザとAPI(0.56)の方が翌日の聞き直し(0.44)より一致し、AIモードでは両者が近い値でした(0.38対0.34)。AIモードでは、外部の出典が付く割合がブラウザ94%に対してAPI82%と差があり、同日82ペアのうちブラウザだけに出典があった回が11回ありました。出典の有無という点では、方式の差が残ります。
ただしGoogleの2つは、APIとの突合が7日分、ブラウザの翌日比較が59〜61ペアと少なく、ChatGPTのような質問単位の区間推定はしていません。ここまでのGoogleの数字は点推定の比較で、標本の誤差で差の向きが入れ替わらないとまでは言えません。
Surferの「出典の重なり4%」と当社の0.40の開きは、測り方の違いで説明がつきます。Surferは出典を「sources」として数えており、ページ単位と読めます(記事に明記はなく、当社の読みです)。ページ単位の一致はドメイン単位より必ず低くなります。SurferではAPI側の約25%が出典を返さず、これを不一致に数えると一致度はさらに下がります。出典の件数もブラウザ16件対API7件と開いていて、Jaccardの上限は0.44です。位置情報と言語の指定はなく、モデルはGPT-5とGPT-5.1-miniです。当社はドメイン単位で、両側に出典がある回を比べ、片側なしは別に報告し、日本・日本語で聞いています。どちらかが誤りというより、測っているものが違います。
一方、同じAPIに翌日聞き直したときの一致は、ブラウザと同じ8月20日から9月5日の期間で0.65から0.69(172ペアと176ペア)で、ブラウザの0.40より高く、差の95%区間(無料相当で+0.11から+0.38、有料相当で+0.18から+0.40)はゼロを含みません。Promptwatchのブラウザはティアとモデルの版が非開示なので、今回の構成どうしの比較です。少なくともこの構成では、ブラウザ側の揺れがAPI側より大きい、という読みになります。
同じ日に聞き直した場合も、揺れは残ります。同じAPIに同じ質問を7回投げた当社の実測(2026年8月24日・GPT-5.5)では、「LLMO対策ができる会社は」で0.44、「中小企業におすすめのLLMO対策会社は」で0.21でした。この7回はモデル(GPT-5.5)も質問(会社を推薦させる型で、最も揺れる型)も本分析と違うので、翌日の0.65と大小は比べられません。学術研究の0.233は24時間以内の聞き直しで、当社は暦日で連続する2日(時刻差は最大36時間)を使っているため、条件は同じではありません。
ブラウザ勢が主張する「ブラウザとAPIの差」が、同じブラウザに聞き直したときの差を上回るという証拠は、出典の顔ぶれでは、ChatGPTで見つかりませんでした。GoogleのAI検索も点推定では同じ傾向ですが、区間推定はしていません。後述のとおり、回答の中身であるブランドの顔ぶれでは、商品推薦4問のChatGPTに限り差が見つかりました。
Geminiは本当に別物。Perplexityも構造的に違う
ここまでの話を、すべてのAIに広げることはできません。Geminiだけは、翌日聞き直せば0.36一致するのに、ブラウザとAPIを比べると0.10(無料相当)と0.06(有料相当)しか一致しませんでした。外部の出典が付く割合も、ブラウザ85%に対してAPIは無料相当92%・有料相当44%と、無料相当と有料相当の2つの構成(モデルも異なります)で逆方向に割れます。Geminiを測るなら、ブラウザかAPIかと、モデルとティアの確認は必須です。
補足として、Perplexity(API側はsonar/sonar-pro)もブラウザとAPIで系統的に違います。ブラウザの翌日一致度は0.68、APIも0.70から0.72と両方安定しているのに、ブラウザとAPIの間の一致は0.29です。APIは1回に約16件、ブラウザは約9件の出典を返し、ブラウザ側の出典の60%はAPI側にも含まれていました。この記事ではこれ以上立ち入りません。
まとめると、この12問の出典の顔ぶれで見る限り、ChatGPTでは、ブラウザかAPIかで結果が変わる証拠は見つかりませんでした。出典の区間推定をしたのはChatGPTだけで、ほかは点推定の比較です。その範囲で、Google AI Overviewsは同じ傾向、Google AIモードは顔ぶれの差が小さく出典の有無に差があり、GeminiとPerplexityは今回の構成では方式で出典の顔ぶれが変わりました。
ブランドの顔ぶれで見ると、ChatGPTだけ方式間の差が揺れを上回る
出典の次は、答えの中身です。業界の主張(Surferのブランド重なり24%)も、実務で使うSoVも、実体はブランドです。同じ期間の回答から、本文に登場した会社名・製品名・サービス名を抽出し(抽出の条件は参考文献に記載)、出典と同じ3比較をブランドの顔ぶれで行いました。12問のうちブランドが安定して出るのは商品推薦の4問(会計ソフト・ランニングシューズ・ビジネスリュック・スマートフォン新機種)で、両側にブランドが出たペアだけで一致度を測っています。
| AI(ブランドの顔ぶれ) | ブラウザ対API(同日) | ブラウザに翌日もう一度 | APIに翌日もう一度 |
|---|---|---|---|
| ChatGPT | 0.17(無料相当)/0.16(有料相当) | 0.27 | 0.23 |
| Google AI Overviews | 0.29 | 0.37 | 0.44 |
| Google AIモード | 0.22 | 0.23 | 0.20 |
| Gemini | 0.28/0.26 | 0.32 | 0.44/0.53 |
| Perplexity | 0.18/0.17 | 0.20 | 0.34/0.41 |
出典では方式間の差が翌日の揺れを上回る証拠が無かったChatGPTが、ブランドでは逆になりました。同日のブラウザ対APIの一致(0.17)は同じブラウザの翌日(0.27)を下回り、質問を単位にしたブートストラップ(5,000回)による差の95%区間は、無料相当で−0.10(−0.196から−0.048)、有料相当で−0.11(−0.234から−0.044)とゼロを含みません。GeminiとPerplexityでは区間がゼロを含みます(Gemini有料相当−0.058、Perplexity sonar-proで−0.032)。片側だけにブランドが出たペアを不一致(0)として含めても、無料相当0.16対0.24、有料相当0.14対0.24で関係は変わりません(両側ともブランドが出なかったペアは別枠で、ChatGPTでは各比較の6割前後を占めます)。この検定は8構成を同時に調べた探索的分析で、多重比較の補正はしていません。
もう1つ、この区間は抽出済みのブランド集合を固定して質問だけを再標本化したもので、抽出モデルの揺れは含めていません。同一本文を再抽出したときの一致はJaccard 0.86・第一推奨86%で、観測した方式間の差(−0.10から−0.11)はこの抽出ノイズと同程度の大きさです。抽出をやり直せば「区間がゼロを含まない」という判定が変わる可能性があります。偶然でないか、抽出の揺れを含めても差が残るかは、事前登録済みの追試(2026年9月7日開始予定。抽出の反復を含む再標本化で区間を再計算)で確認します。
Geminiは出典と逆でした。出典では全AI中最大の方式差(0.10対0.36)が出たのに、ブランドでは方式差がありません。出典に何を引くかと、どのブランドを挙げるかは別々に動いています。
差の中身を質問別に見ると、最大の寄与は会計ソフトです(同日0.43対翌日0.68)。会計ソフトを除いた3問でも差は残り(−0.10が−0.05に縮小。3問では質問単位の区間が組めないため、記述的な差として報告します)、4問すべてで同じ方向でした。1問だけの現象ではありませんが、効果の大きさは質問に強く依存します。
最も鮮明な逆転は、会計ソフトの第一推奨(回答が最初に挙げる製品)に出ました。
| ChatGPT・会計ソフトの第一推奨(無料相当) | 一致率 |
|---|---|
| 同じブラウザに翌日もう一度 | 81%(13/16) |
| 同日のブラウザ対API | 18%(3/17) |
| 同じAPIに翌日もう一度 | 12%(2/16) |
ブラウザは翌日も81%同じ製品を第一推奨に挙げるのに、APIは自分自身でも翌日12%しか一致しません。出典で見た安定性(API 0.65対ブラウザ0.40)と逆向きの逆転が、この質問では起きています。
ただしこれは会計ソフト1問・16〜17ペアでの観察です(有料相当では53%/81%/56%で、逆転は弱まります)。第2のブラウザ環境(自社の実ブラウザ計測。初回データは2026年9月6日取得済み、事前登録した本実験は9月7日開始予定)で再現するかを検証し、続報で出します。
ブランドの結論はこうです。今回の商品推薦4問では、ChatGPTに限り、方式間の差が翌日の揺れを上回りました。ブラウザ側(Promptwatch)はモデルの版とティアが非開示なので、「今回のブラウザ環境とAPI構成の間の差」であり、取得方式だけの効果とは断定できません。「ブラウザとAPIは別物」とまでは言えませんが、この2つの環境の間では、カテゴリーによって答えの顔ぶれが変わります。GeminiとPerplexityのブランドには方式差の証拠がなく、出典とブランドで方式への感度が逆転するモデルもあります。どちらか一方だけを測って「差がある/ない」と言うことはできません。
答えを決めているのは、ブラウザかAPIかではなく「条件」と「揺れ」
ここまでの出典の顔ぶれでは、ChatGPTで方式間の差が翌日の揺れを上回る証拠は見つかりませんでした(GoogleのAI検索は点推定で同じ傾向。ブランドではChatGPTに限り差あり)。では、何が結果を動かしているのか。
ひとつは条件です。モデルとティアの構成(Geminiの無料相当と有料相当で外部の出典が付いた割合が92%対44%)、位置情報(パイロットで0.29から0.44。効果としては未確認)、質問文(言い回しを変えると第一推奨が割れた参考例)。実測した3つは、条件を変えるとそれぞれ数字が動きました(尺度が違うので大きさどうしの比較はしていません。位置情報と質問文は反復ブロックの無い単発の観察なので、揺れとの分離はできていません。効果として確かめられているのはモデルとティアの構成だけです)。ログインと履歴(メモリによる個人化)は、OpenAIの仕様上、同じ方向に働きます。
もうひとつはAI自身の揺れです。条件を変えなくても、翌日の一致はブラウザ0.40・API 0.65、同じ日に7回聞いても0.21から0.44です。この揺れは消せません。繰り返して率にするしかありません。
モデルは、版が変わるだけで答えが動く
条件のうち、最も見落とされやすいのがモデルの版です。同じ名前のAIでも、中身の版は入れ替わっています。版を固定して比べた実測が1つと、原因は特定されていないものの、サービス側の変化で引用が大きく動いた観測が1つあります。
Chenら(2024)は、GPT-4に同じ素数判定の問題を同じ手順で解かせ、2023年3月の版では84.0%の正答率だったものが、同年6月の版では51.1%に落ちたと報告しました。どちらもAPIで版を固定して取ったスナップショットです。問いも指示も同じで、変わったのはモデルの版だけでした。
seoClarityは数百万件のChatGPTの応答を追跡し、1プロンプトあたりの平均引用数(回答に付く出典の数)が2026年3月8日に5市場中4市場で下がり、4月19日には米国・英国・ドイツでいずれも80%超落ちたと報告しています(2026年6月19日更新)。5月には3月以前の水準に向けて戻りました。同社は原因を断定せず、「大きなアルゴリズム変更の可能性が高い」と書いています(当社訳)。版変更と確認されたものではなく、検索索引や引用の仕組みの変更でも起こりえます。それでも、出典の付き方が数週間で8割減り翌月に戻った事実は、引用を数える計測すべてに関わります。
当社がこの記事で数値を出すときに、取得日とモデルの版(gpt-5.6-luna/gpt-5.6-sol、gemini-3.5-flash/gemini-3.1-pro-preview、sonar/sonar-pro)を明記しているのは、この理由からです。
ただし、ここで固定できているのはモデルIDまでです。これらは日付付きの不変なスナップショットではなく、提供元が同じIDのまま中身を更新することがあります。その場合、同じAPIの翌日の揺れやブラウザとの差には版の変更が混ざります。/v1/modelsで確認できたのも、取得日にそのIDが存在したことまでです。「版を固定した基準」と言えるのは、不変のスナップショットIDが提供されているモデルに限ります。
主要ツールは「どのAIか」は言うが、「どの版か」は言わない
市販のAI可視性ツールは、この条件をどこまで開示しているのでしょうか。当社が各社の公式ページで確認した範囲は、次のとおりです。
| ツール | 開示していること | 開示していないこと | 確認日 |
|---|---|---|---|
| Profound | 取得対象9サービス、ブラウザから取得、日次 | モデルの版、ティア、ログイン状態 | 2026年8月29日 |
| Promptwatch | 対応9サービス、ChatGPTなど主要サービスは画面(UI)をスクレイピング、Claudeなど一部はプロバイダーのAPI、日本語を含む多言語対応 | モデルの版、ティア、ログイン状態 | 2026年8月29日・9月4日 |
| Otterly | 対応7サービス、ブラウザに投稿する方式、「パーソナライズの偏りを避ける」、ClaudeのみAPI | モデルの版、ティア、ログイン状態 | 2026年8月29日・9月4日 |
| Ahrefs Brand Radar(API) | 取得元(chatgpt・claudeなど提供元の単位) | モデル名と版(APIで指定も取得もできない) | 2026年8月19日 |
| Seer GenAI Answer Tracker、xfunnel | 「複数のLLM」 | 具体的なモデル(Ahrefsの比較記事に「specific models not disclosed」と記載) | 2026年9月4日 |
共通しているのは、「どのAIか」は開示し、「どの版か・どのティアか・ログインしているか」は開示していないことです。ChatGPTとGeminiで測っている、までは分かります。その日のChatGPTがどの版で、無料版か有料版か、ログインしているかは分かりません。実測に照らせば、開示されていない側の項目こそが答えを動かす条件です。
これは各社が何かを隠しているという話ではありません。ブラウザ版のChatGPTは利用者側からモデルの版を指定できず、既定の版はサービス側が切り替えます。ブラウザから取る方式を選んだ時点で、版を明示するのは構造的に難しくなります。
Profoundの強みは本物です。ただし、日本の中小企業の強みではない
ブラウザ方式の旗手であるProfoundには、他社にない強みがあります。実際のユーザーがAIに投げたプロンプトのデータ(Prompt Volumes)です。公式ページによると15億件超の実ユーザープロンプトを持ち、データは「複数の、二重の同意を得た消費者パネル(double-opt-in consumer panels)からライセンス取得」し、「人口統計と地理の偏りを統計モデルで補正」しています(2026年9月4日取得・当社訳)。対象国は米国・カナダ・英国・ドイツ・フランス・イタリア・スペイン・オーストラリア・ブラジル・韓国の10か国で、日本は含まれていません。料金はStarterが月99ドル、Growthが月399ドル(いずれも年払い)で、Prompt Volumesが使えるのはEnterprise(個別見積)のみです(2026年9月4日確認)。
ここまでが事実です。ここからは当社の解釈です。
第一に、パネル由来のデータにはモニターバイアスが避けられません。参加者は報酬を目的に登録していることが多く、高額商材やBtoBほどターゲット層と離れていきます。第二に、日本語の実ユーザープロンプトのデータを持つツールは、当社が確認した範囲ではまだありません。日本語対応を掲げるツールはありますが、自分で用意した日本語の質問を投げる方式であって、日本のユーザーが実際に何を聞いているかのデータではありません。第三に、どの質問を採用するかは、どのツールを使っても最終的に人が判断することになります。
Profoundの強みは本物です。ただしそれは、Enterprise契約を結べる、対象10か国で事業を行う企業の強みです(日本は対象外)。日本の中小企業やBtoB企業がそのまま使える強みではありません。だからこそ、条件をそろえて自分で測る設計が要ります。
条件を整えて、APIで繰り返し測る
LLMOの目的とは、「誰が、どのAIに、どのティアで、どこから、どんな言葉で聞いたとき」という特定の条件のもとで、自社が推奨されることです。条件を決めずに聞いて推奨されても、誰にとっての推奨なのかは説明できません。質問文を「LLMO対策ができる会社は」から「中小企業におすすめのLLMO対策会社は」に変えただけで、第一推奨が7回一致から4社に割れた実測が、その一例です(1日・2問・各7回の単発比較で、質問文の効果と生成時の揺れは分離できていません。効果として確かめるには反復ブロックを含む追試が要ります)。
APIでは、モデルの版、位置情報、メモリなし、検索ツールの設定、ティアに相当する設定をすべて明示した上で質問できます。条件が明示された揺れは繰り返せば統計として扱え、非開示の揺れは扱いようがありません。ChatGPTでは、APIの翌日一致度0.65はブラウザの0.40より安定していました。
ブラウザ版もAPI版も、動いているモデルは同じ系統です。違うのは、どの版を指定できるかと、モデルの外側に何が乗っているかです。ブラウザ版にはメモリ、履歴、表示枠、その日の既定の版が乗り、APIにはそれがありません。計測は3段階で設計するのが理にかなっています。
1段目:API・検索なし
モデルが学習で持っている知識だけで答えたとき、自社がどう扱われるかを見ます。検索の索引も画面も介在しない、最も条件の少ない基準点です。ここでの言及率が、検索に頼らない基準になります。
2段目:API・検索あり
Web検索を有効にして、同じ質問を投げます。1段目との差に、検索の索引を通じて自社がどう扱われるかが表れます。施策の効果を判定するには、施策の前後で同じ条件を比べる必要があります。
3段目:ブラウザ・顧客に近い設定
想定する顧客に近い設定(ログイン状態、メモリ、業種や立場の指定)でブラウザ版に聞きます。最も顧客に近い数字ですが、条件を同じにして繰り返すことが難しいため、1段目と2段目の基準がなければ読めません。2段目から3段目へ移ると、画面・メモリだけでなく、取得経路、検索基盤、製品側の指示、非開示の版やティアも同時に変わります。差をそのまま「画面・メモリ・個人化の影響」と呼べないので、ログインなしの匿名ブラウザも基準に置き、条件を一つずつ変えて差を分ける設計が要ります。Geminiのように方式で本当に変わるAIと、ブラウザにしかない要素(表示枠・ティアごとの既定モデル)を見るのも、この段です。
3段階のどれも、1回では足りません。学術研究は、ブランドの検出率を見るなら1プロンプトあたり1日7回以上、出典の顔ぶれまで見るなら8回以上を推奨しています(Schulteら・2026年)。Profoundも日次か週次で複数サンプルを集計するよう勧めています。回数を重ねて率にして、初めて差分が読めます。
条件を明示したAPIで基準を取り、その上にブラウザの差分を重ねる。順番が逆になると、何が効いたのかを判断できない。
留保をひとつ書いておきます。3段目の計測は、当社でもまだ設計の段階で、実測の数字を持っていません。この記事の3段階は、実測で裏づけた結論ではなく設計の提案です。実測ができたら、別の記事で数字を出します。
計測会社に聞き、レポートに書いてもらう4項目
条件を明示して測るか否かは、AI可視性ツールが示すSoV(Share of Voice。回答の中で自社が言及・推奨された割合)の読み方を変えます。条件を明示しないSoVは何の割合か分からず、条件を決めて繰り返し測った推奨率は「その条件のユーザーに、いま何割の確率で推奨されるか」として読めます。
計測会社に聞くべきことは、「ブラウザですか、APIですか」ではなく次の4つです。次のレポートからこの4項目を書いてもらってください。
- どのAIを、どのティア(無料/有料)で、どのモデルの版で測っているか。ティアとモデルの版が変わると結果も変わります(Geminiの引用率は92%対44%)。尺度が違うので、ブラウザかAPIかとの大小比較はしません
- API取得かブラウザ取得か。ブラウザなら、ティアとログイン状態。ログインなしなら、それは「新規ユーザーの条件」だと明示されているか
- 取得日時と、同じ質問を何回投げているか。同じ方法で聞き直しても、前日と翌日の出典を合わせた名簿のうち、両日に共通しないものがブラウザで約6割、APIで3割強あります(当社実測。翌日の一致度0.40、0.65〜0.69の裏返しです)。1回の測定では、ブラウザとAPIの差どころか何の差も読めません
- 言語と位置情報、そしてそのSoVはどの条件で聞いた割合か。位置情報の1行で出典一致が0.29から0.44に動いた例があります(当社パイロット・効果は未確認)。条件を説明できない推奨率は、他社との比較にも、打ち手の評価にも使えません
前月との比較を出すときは、その間にモデルの版が変わったかどうかも併記してもらいます。版が変わっていれば上下の一部はモデルのせいです。変わっていなくても、AI自身の揺れ、検索索引の更新、競合側の変化、標本の誤差は残ります。それらを見た上で、条件と自社の施策の効き方を読みます。
補足:なぜ「ブラウザが本物」と言われ続けるのか(当社の解釈)
ここからは事実の並置と、当社の解釈です。
APIで測るのに特別なものは要りません。キーを取り、数十行のコードを書けば動きます。この記事の「同じAPIに7回」の実測は半日かからず回せました。一方、ブラウザから取り続けるには、Cloudflareの検出回避、住宅用プロキシの費用、ログイン状態の保守が要ります。スクレイピングを請け負う業者cloro.devは、インフラだけで月3,000〜8,000ドル規模になると自ら説明しています。Profoundは50か国以上でブラウザから毎日取得する体制を強みとして掲げています。この費用と装置が、参入の壁です。
もしAPIで足りるなら、この壁は消えます。誰でも計測を始められます。だから「APIは別物だ」という主張は、その方式を売る側にとって守らなければならない主張になります。
断っておくと、これは各社の動機を断定するものではありませんし、ブラウザでしか取れないものは実在します(ブラウザ固有の表示枠、製品側が乗せる指示の層、ティアごとの既定モデル)。壁が人工的だと言いたいのではなく、壁の存在が主張の背景にありうる、という話です。
当社の弱点も書いておきます
当社のAI PulseはAPI方式です。この記事は自社に有利な結論に見えるので、限界を明記します。
- ブラウザ版の実体験そのものは測れません。表示枠や、ティアごとの既定モデルの挙動はAPIから見えません。3段階の3段目(顧客に近い設定のブラウザ)は当社も未実測です
- ブラウザとAPIの差の実測は17日分・12問で(API側単独は20日分)、ブラウザ側に使ったPromptwatchのモデルの版・ティア・ログイン状態は非公開です。API側はgpt-5.6-luna/gpt-5.6-solと版を指定しているので、この比較は取得方式とモデル条件を同時に変えたものです。方式だけの影響は分離できていません。Google AI OverviewsとAIモードは、2026年8月27日以降にAPI側で外部の出典が取得できなくなったため、API側は8月26日までの10日分、ブラウザとの突合は7日分で、ブラウザの翌日一致も同じ8月26日までの窓で計算しています
- 12問は当社が想定顧客向けに選んだ固定の質問で、実際のユーザーの質問分布を代表しません。ブートストラップの区間は、この12問の中のばらつきを表します
- ブランドで見つかったChatGPTの方式差は、ブランドが出る商品推薦4問(両側ブランドありペア193)に基づき、最大の寄与は会計ソフト1問です。会計ソフトを除いても差は残りますが、効果の大きさは質問に強く依存し、一般化には質問数を増やした追試が必要です。追試は事前登録方式(質問16問・同日反復付き)で2026年9月7日開始予定です
- 「同じブラウザに翌日聞き直した一致度」は最大36時間の時間差を含むため、ニュースや検索索引の更新も「揺れ」に入ります。同じ時間差を含むAPIの翌日一致が0.65から0.69と高いことから、時間差だけで0.40まで下がるとは考えにくいものの、同時刻の反復ではありません。同日のブラウザ対APIと翌日のブラウザ対ブラウザは、条件が完全には揃っていません
- 日本語の実ユーザープロンプトのデータは、当社も持っていません。質問文は想定顧客の言葉で当社が設計しており、その選定にも人の判断が入ります
- 当社の日次計測も、学術研究が推奨する反復回数(1プロンプトあたり1日7回)を常時は満たしていません
まとめ
ユーザーはブラウザでAIを使う。これは事実です。しかし、そこから「計測会社のブラウザで測れば本物」とは言えません。ブラウザに翌日もう一度聞くと出典は4割しか一致せず、計測会社のブラウザはユーザーのブラウザでもないからです。
ブラウザとAPIの出典の一致度は、当社が測ると、同じブラウザに翌日聞き直した一致度と点推定で同じでした(0.40対0.40・差−0.003)。方式の差が揺れを上回る証拠は得られませんでしたが、同じだと証明したわけでもありません。この12問の出典の顔ぶれで見る限り、ChatGPTでは、ブラウザかAPIかで結果が変わる証拠は見つかりませんでした。出典の区間推定はChatGPTだけで、ほかは点推定の比較です。その範囲で、Google AI Overviewsは同じ傾向、Google AIモードは顔ぶれの差が小さく出典の有無に差があり、GeminiとPerplexityは今回の構成では方式で出典の顔ぶれが変わりました(ブランドの顔ぶれでは、GeminiとPerplexityとも差の区間がゼロを含みます)。
一方、回答の中身であるブランドの顔ぶれでは、今回の商品推薦4問で、ChatGPTに限り、方式間の一致(0.17)が翌日の揺れ(0.27)を下回りました(探索的分析・事前登録済みの追試で確認予定)。会計ソフトでは、ブラウザの第一推奨が翌日も81%同じなのに、今回のAPI構成は自身の翌日とも12%しか一致せず、方式間の18%はこのAPI側の入れ替わりでほぼ説明できます。今回のブラウザ環境とAPI構成の間では、カテゴリーによって答えの顔ぶれが変わります。
結果を動かしているのは、方式ではなく条件と揺れです。条件のうち実測で確かめたのはモデルとティアの構成で、位置情報と質問文は単発の参考例です。主要ツールは「どのAIか」は開示しても「どの版か」は開示していません。条件を開示しない数字は、何を測ったか分からない数字です。
だから当社は、条件を明示したAPIで検索なし・検索ありの基準を取り、その上に顧客に近い設定のブラウザの差分を重ねる、3段階の設計を提案します。そして次のレポートから、モデルの版・取得方式・回数・言語と位置情報の4項目を書いてもらってください。
当社のAI可視性計測「AI Pulse」は、測る入口とモデルの版、回数を明示し、観測した回答の原文を保存・開示することを前提にしています。計測で自社の位置を確かめたあと、第三者に語られるための広報PR施策(パブリシティ)まで一続きで進めたい方は、お気軽にご相談ください。
関連記事:

LLMO対策とは|費用相場と頼める会社3タイプ【中小企業向け】
LLMO対策の費用相場と、SEO会社・ツール型・PR会社発の3タイプの選び方を中小企業向けに解説。契約前に確認すべき5つの計測指標つき。
株式会社ガーオン
Claudeは何を「読んで」答えている?AIに拾われる文の書き方
生成AI「Claude」は、ページ全文でも要約でもなく、検索エンジンBraveが本文からそのまま切り出した約150字の抜粋を「意味」で選んで読んでいた。当社の実測でClaudeの検索メカニズムを解剖し、キーワード詰め込みに頼らずAIに拾われる文を書く5つのポイントを解説します。
株式会社ガーオン

LLMO対策のやり方|サイトを読む4種類のAIボットと優先順位
サイトを読みに来るAIボットは、学習クローラー・インデックス作成クローラー・ユーザー指示ボットの3種類。これに新しい窓口のMCPを加えた4経路ごとに、仕組みと効くLLMO対策、優先順位を、自社サイトの実測と実装例で解説します。
株式会社ガーオン
参考文献・参考リンク
- 当社実測・本分析(2026年8月17日〜9月5日):API側=当社AI Pulse計測基盤(12問×毎日×13識別子の予定3,120会話のうち取得できた3,075会話。欠測45件は集計から除外。引用31,544行)、ブラウザ側=Promptwatch(UIスクレイピング、モニター「API/ブラウザテスト」:countryCode JP・languageCode ja-JP・ペルソナなし、8月20日〜9月5日、予定1,224回答のうち1,173回答。欠測51件はGoogle AI Overviewsの未表示36件を含み、8月23日に17件、8月29日に10件、9月4日に7件が集中。集計では欠測として除外)。同一質問×同日×モデル対応で突合(ChatGPT 199ペア)。13識別子の内訳はChatGPT 2(gpt-5.6-luna/gpt-5.6-sol)、Gemini 2(gemini-3.5-flash/gemini-3.1-pro-preview)、Perplexity 2(sonar/sonar-pro)、Claude 2(claude-haiku-4-5/claude-opus-4-8)、Grok 2、Google AI Overviews・AIモード、Llama。出典ドメインはwww.を除去し、画像サムネイル・検索エンジン自身のホストを除外。「外部の出典が付いた割合」は両側ともこの除外後に1件以上残る回答の割合。翌日一致度は同一質問×同一モデルの暦日で連続する2日(時刻差は最大36時間)で両日とも出典がある回のみ。Schulteらの|Δt|≤24時間とは条件が異なる。ChatGPTの一致度の差の95%区間は、質問を単位にしたブロックブートストラップ(5,000回)で算出。Google AI Overviews/AIモードのAPI側は8月26日まで。ブラウザ側の一意な回答は同一質問×日で最初の1件。モデルIDはOpenAI /v1/models で2026年9月4日に確認
- 当社実測・ブランド検証(2026年8月20日〜9月5日・本分析と同一データ):回答本文から会社名・製品名・サービス名・ブランド名を抽出(抽出モデルgpt-5.6-luna・抽出プロンプト版v2-20260906を固定。一般名詞・官公庁・公的制度・出典サイト名は対象外)。表記の正規化(NFKC・小文字化・括弧書き除去・法人格除去)はコード側で固定。同一本文を2回抽出した再現一致はJaccard 0.86・第一推奨86%(抽出ノイズの床)。両側にブランドが出たペアに限定した3比較と、質問を単位にしたブロックブートストラップ(5,000回)。片側だけブランドありを0に含めた再計算を併記し、両側なしペアは別枠。会計ソフト除外の3問感度分析は記述統計のみ(質問単位の区間が組めないため)。8構成同時の探索的分析で多重比較は未補正。ペア単位の生値3,869行・抽出キャッシュ2,567回答・算出スクリプトは社内リポジトリ(ai-pulse)に保存しており、条件の照合が可能
- 当社実測・同日7回(2026年8月24日):GPT-5.5・Responses API・web_searchツール有効(使用はモデル判断)・位置情報JP・2質問×各7反復。回答本文の引用注釈(annotations)のドメイン集合でペアワイズJaccard(「LLMO対策ができる会社は」0.437/「中小企業におすすめのLLMO対策会社は」0.214。検索アクションが返した候補URLまで含めた集合では0.363/0.251)。第一推奨は本文中で最初に現れる登録社名で判定(AtoZ Designを追加登録して再集計)。「LLMO対策ができる会社は」で7回中7回同一、「中小企業におすすめのLLMO対策会社は」に変えると7回で4社
- 当社 user_location A/B検証(2026年8月13日・パイロット)。位置情報指定で出典一致0.29→0.44(当社計測基盤内のデータによる参考値)
- Schulte et al.「Measuring the Stability of AI Visibility」(arXiv:2604.07585, 2026年4月)。Appendix B「all data collected via web-interface scraping」。Table 6:ChatGPT・|Δt|≤24時間・引用が出た回のみ・出典ドメインJaccard 0.233/ブランドJaccard 0.437。結論(§7)「ブランド可視性の監視は1プロンプトあたり1日7回以上、出典レベルは8回以上」(当社訳)
- Chen, Zaharia & Zou「How Is ChatGPT's Behavior Changing Over Time?」(Harvard Data Science Review, 2024/arXiv:2307.09009)。GPT-4の素数判定(chain-of-thought)で2023年3月版84.0%→6月版51.1%
- seoClarity(Mitul Gandhi)「Tracking the Decline of ChatGPT's Citations: A Global Trend Analysis」(2026年6月19日更新・2026年9月4日取得)。1プロンプトあたりの平均引用数が2026年3月8日に5市場中4市場で低下、4月19日に米・英・独で80%超低下、5月に回復。原因は "likely a major algorithmic shift" と記述。 www.seoclarity.net/…n-decline-analysis
- OpenAI「ChatGPT — Release Notes」2025年4月10日の項(2026年9月4日取得)。saved memoriesに加えchat historyを参照する方式の追加。 help.openai.com/…tgpt-release-notes
- OpenAI「Memory FAQ」(2026年8月29日取得)。"memory helps ChatGPT automatically remember useful context from your chats, files, and connected apps to personalize your experience" / "Temporary Chats do not use existing memories or create new memories."
Memory FAQ | OpenAI Help Center
Learn more about managing memory in ChatGPT.
OpenAI Help Center
- Profound「Answer Engine Insights」製品ページ(2026年8月29日取得・9月4日再取得)。"Other tools pull AI responses from the API. We capture directly from the browser" / "We focus on front-end user experiences rather than API calls so you're getting results from the real websites."、取得対象9サービス(ChatGPT, Perplexity, Claude, Microsoft Copilot, Google AI Overviews, Google AI Mode, Google Gemini, Grok, DeepSeek)、日次実行。モデル版・ティア・ログイン状態の記載なし。 www.tryprofound.com/…er-engine-insights
- Profound「Profound vs. Peec AI」(2026年8月29日取得)。"not API calls, which return different results than what real users see"。 www.tryprofound.com/…rofound-vs-peec-ai
- Profound「AEO tools guide 2026」(2026年8月29日取得)。"tracked daily on front-end browsers across 50+ countries"。 www.tryprofound.com/…mization-platforms
- Blyskal & Rajpal(Profound)「AI Search Volatility」(2025年7月17日)。2025年6月と7月、約8万プロンプト/プラットフォーム。引用ドリフト=AI Overviews 59.3%・ChatGPT 54.1%。 www.tryprofound.com/…-search-volatility
- Profound「Prompt Volumes」製品ページ(2026年9月4日取得)。"Profound licenses conversations from multiple, double-opt-in consumer panels of real answer engine users" / "we apply statistical modeling that corrects for demographic and geographic biases" / 1.5+ billion real user prompts / 対象10か国(日本なし)。 www.tryprofound.com/features/prompt-volumes
- Profound「Pricing」(2026年9月4日取得)。Starter 99ドル/月、Growth 399ドル/月(年払い)、Enterprise個別見積。Prompt VolumesはEnterpriseのみ。 https://www.tryprofound.com/pricing
- Surfer「Scraped AI Answers vs. API Results from LLMs」(2026年2月3日更新・2026年8月23日取得、9月4日再取得)。1,000回実行、出典(sources)重なり4%、ブランド重なり24%、API23%検索非発火、API側の約25%は出典なし、出典件数はブラウザ16件対API7件、モデルはGPT-5/GPT-5.1-mini、位置情報・言語の記載なし。冒頭の引用の原文="These results confirm that API responses differ very strongly from scraped responses in the LLM." / "monitoring responses from API as a proxy for your AI visibility is totally wrong."(Wojciech Korczyński氏)。 surferseo.com/…rs-vs-api-results/
- Promptwatch「How Promptwatch collects data」(2026年8月29日取得)/公式サイト(2026年9月4日取得)。"API models are called through their provider APIs, on purpose." / 公式サイト "Promptwatch collects data by scraping the UI interfaces of the LLMs used every day by hundreds of millions of people." / "Real crawl data from user interfaces, not APIs."、対応言語に日本語を含む。 promptwatch.com/…atch-collects-data
- Otterly「How OtterlyAI collects data」(2026年7月17日更新・9月4日取得)。"posting questions and prompts through the website of the AI search (like chatgpt.com etc)" / "please note that we only use API for Claude tracking." help.otterly.ai/…lyai-collects-data / 公式サイト "Neutral/Objective Results: Avoids personalization bias (Memory RAG, location, search history)" https://otterly.ai/
- Ahrefs API v3 ドキュメント・Brand Radar(2026年8月19日取得)。data_sourceは提供元の単位で、モデル名・版の指定・取得は不可。 docs.ahrefs.com/…rence/introduction
- Ahrefs「15 of the Best AI Visibility Tools」(2026年2月6日更新・9月4日取得)。Seer GenAI Answer Trackerとxfunnelについて "specific models not disclosed"。 ahrefs.com/…-visibility-tools/
- awoo「awoo GEO Suite」発表(2026年3月18日)。「シークレットモードに近い環境で実施」。 www.awoo.ai/…_geo_suite_launch/
- cloro.dev「ChatGPT Scraper API」(2026年8月25日取得)。住宅用プロキシ・自動ブラウザ群・対策追随のインフラが月3,000〜8,000ドル規模とする同社の説明。 https://cloro.dev/chatgpt/
- OpenAI「Terms of Use」(2026年9月4日取得)。自動的・プログラム的なデータ・出力の抽出の禁止。 https://openai.com/policies/terms-of-use/
(注)本記事の当社実測の主体は2026年8月17日〜9月5日の本分析です。位置情報のパイロット(8月13日)は参考値として併記しています。ブラウザ側(Promptwatch)のティアとログイン状態は非公開です。同日7回の実測は2質問・1日・GPTのみで、質問数を増やした追試が望ましい状態です。検索の挙動・引用の返し方はモデルとAPIの版で変わるため、引用した数値には取得日とモデルの版を明記しています。生データと算出スクリプトはすべて社内リポジトリに保存しており、条件の照合が可能です。