ChatGPTの利用者は、2025年7月時点で約7億人、週に180億件のメッセージが送られていました(Chatterji et al.、NBER ワーキングペーパー、2025年9月)。2026年11月には、OpenAI自身が週12億人と公表しています。その中で自社がどう紹介されるか。AI検索の計測は、この問いに答える仕事です。
計測の出発点は、質問文を決めることです。「顧客はAIに何と聞いているか」が分からなければ、投げる質問を決められません。
言葉を先に決めます。本記事では、利用者がAIに実際に打つ質問文を「実プロンプト」、計測ツールが計測のためにAIへ投げる質問文を「計測用プロンプト」と呼びます。
ところが、実プロンプトは外から見えません。見えるのは、計測ツールの画面に並ぶ計測用プロンプトの一覧と、言及数や引用数、引用率や言及率といった数字、それに「ボリューム」のような推定指標だけです。どれも、実測の顔をしています。
計測用プロンプトは、実物そのものではありません。各社が推測や観測から組み立てたものです。だから同じ「ボリューム」でも、会社が違えば、測っているものが違います。
本記事では、主要ツールの推測方法を5つの流派に整理します。あわせて、公開データから分かる実プロンプトの姿と、「プロンプトボリューム」の読み方をまとめます。最後に、当社の計測データで確かめた結果も示します。
実プロンプトは、外部からは見えない
計測ツール側も、実プロンプトは取得できないと明言しています。Otterly.AI のヘルプセンターは、AI検索エンジンは利用者の質問文を公開していない、と説明しています。実プロンプトをそのまま見られる公開ツールは存在しません。例外は後述するマイクロソフト系の窓だけで、見える範囲も自社サイト分に限られます。
Ahrefsも、自社の方法論の中で線を引いています。Googleの検索ボリュームと、AIの中で実際に聞かれる頻度のあいだに、検証済みの関係はない、という線引きです(Ahrefs 公式の方法論記事)。
なお、2026年11月10日、OpenAI は企業向けの「Businesses in ChatGPT」をベータ公開しました。企業は Business Hub で自社プロフィールを申請・認証でき、「Brand Insights」では言及回数、プロフィール閲覧数、サイトへのクリック数、自社が現れたテーマ(ディスカバリートピック)の集計が見られます。ただし、利用者が入力した質問文(実プロンプト)は含まれません。表示されるのは集計値のみで、一定の件数を超えた場合に限られます。ブランドが利用者と対話する事業者向けエージェントは、当面は米国の EC・オンラインサービス事業者が対象です。日本では、当社も申請しましたがウェイトリストに入りました(2026年11月時点)。実プロンプトには予算や家族構成といった個人の事情が書き込まれるため、プラットフォーム自身の公式画面でも、実プロンプトそのものは出てこないわけです。
したがって、計測ツールが示すプロンプトは、どれも実プロンプトそのものではありません。観測できないものを、別の手がかりから組み立てています。問題は推測そのものではありません。どの手がかりからどう組み立てたかが会社ごとに違い、その違いが数字の意味を変える点にあります。
実プロンプトは、検索キーワードと似ていない
推測の方法を見る前に、対象の姿を確認します。実プロンプトは、検索キーワードと大きく違います。
長く、文脈を含み、長さ自体が動いている
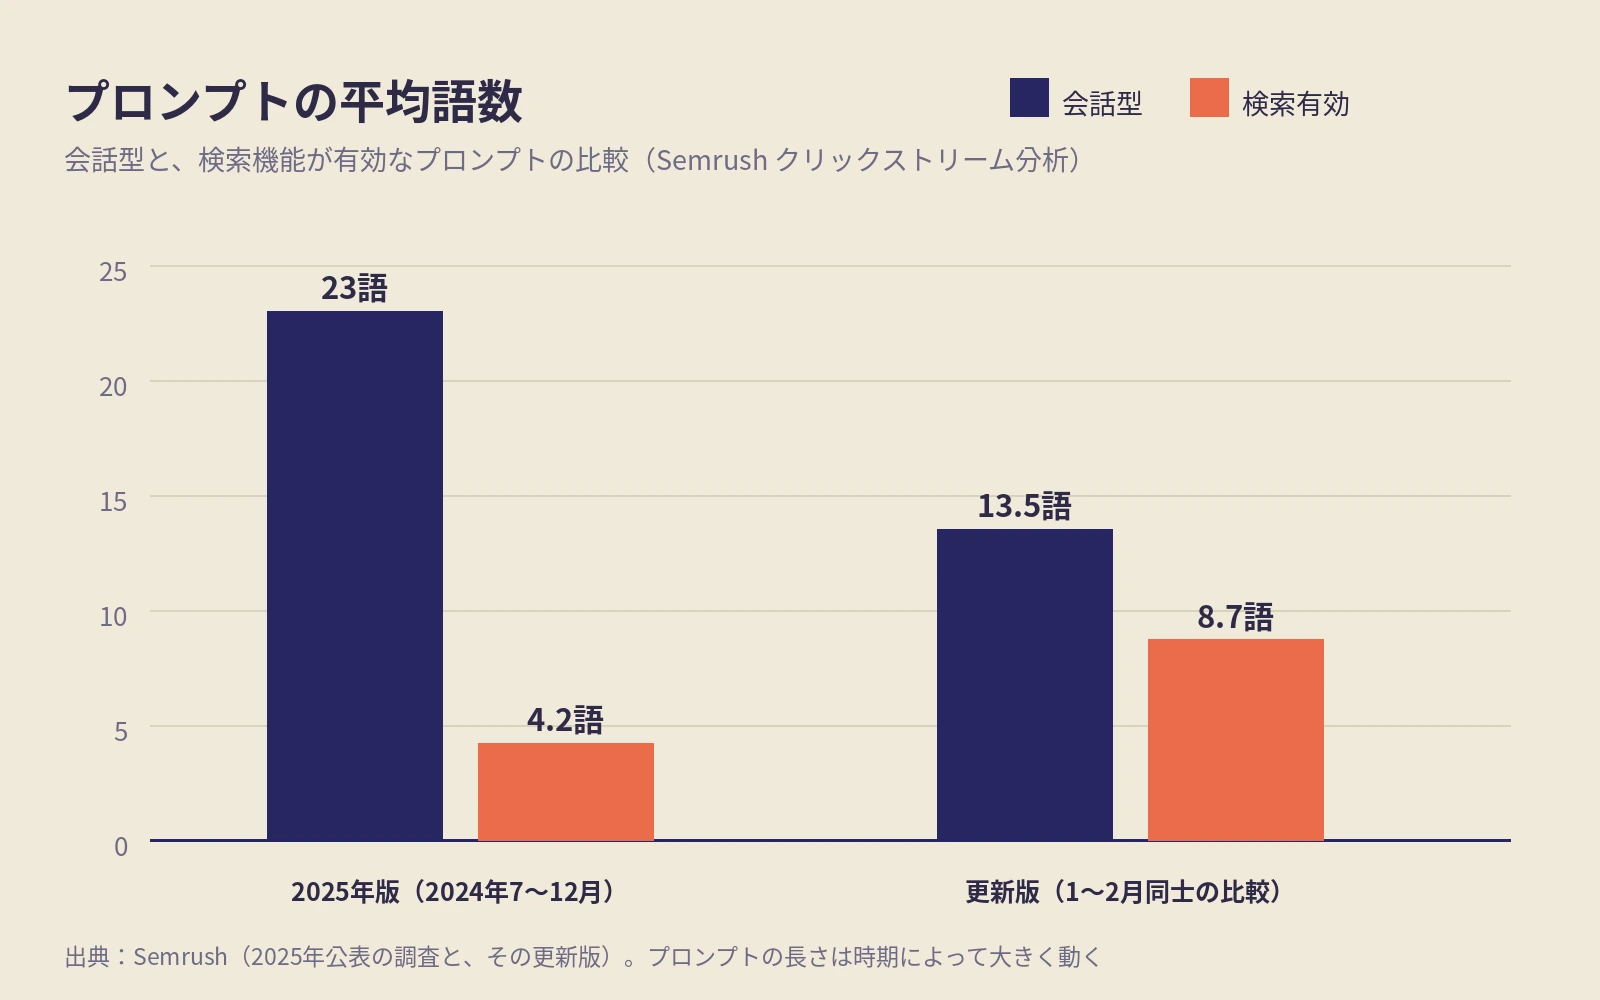
Semrushはクリックストリーム(利用者のブラウザ操作の記録)を分析しました。2025年公表の調査(2024年7〜12月、8,000万行超)では、会話型のChatGPTプロンプトは平均23語、検索機能が有効な場合は平均4.2語でした。4.2語は、Google検索のキーワード並みの短さです。
ただし、長さは固定ではありません。同社の更新(米国のクリックストリーム10億行超)で同じ1〜2月同士を比べると、会話型は平均24.9語から13.5語へ縮み、検索が有効なプロンプトは4.7語から8.7語へ伸びました。時期と使い方で、長さは大きく動きます。「実プロンプトは平均23語」と型にはめると、実態からずれます。
意図の分類にも、既存キーワードにも、当てはまらない
同じ分析では、ChatGPTの質問の約70%が従来の検索インテント分類(ナビゲーション、情報収集、商用調査、取引の4分類)のどれにも当てはまらず、「unknown」に落ちました。同社の更新では、調査期間の大半でプロンプトの65〜85%が既存の検索キーワードのどれにも対応づけられなかった、とされています。一方で、検索語に近い短いプロンプトの比率は2025年10月の18.9%から2026年2月の34.9%へ増えており、姿はなお動いています。
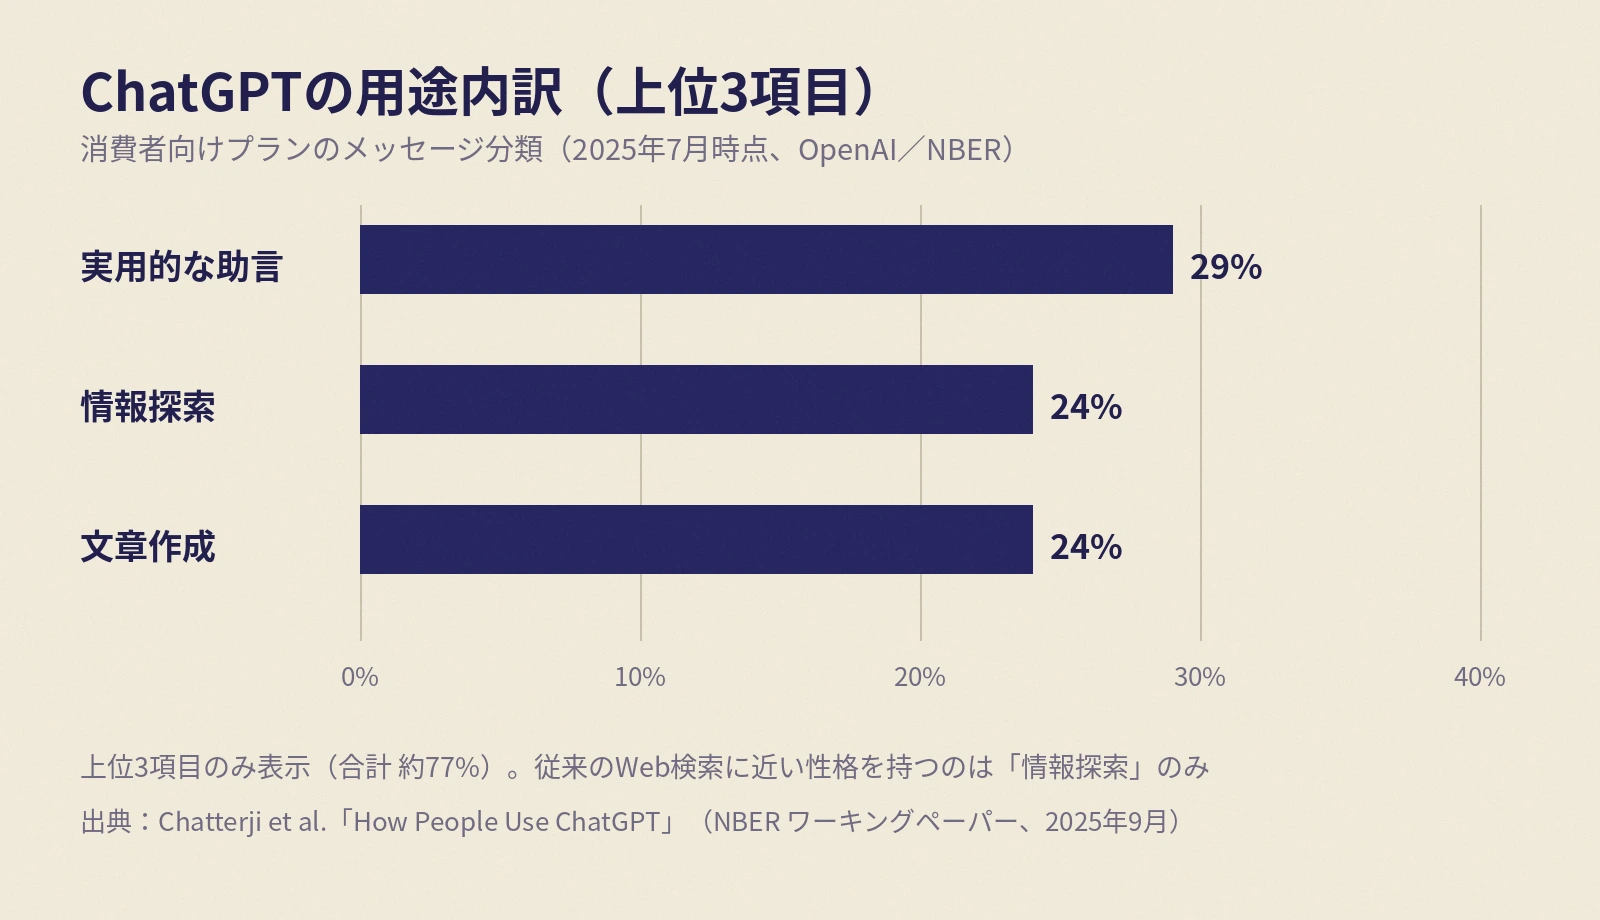
OpenAIと研究者による大規模分析(NBER ワーキングペーパー、2025年9月)でも、構図は似ています。利用の7割超は仕事以外の用途でした。話題の上位は、実用的な助言(約29%)、情報探索(約24%)、文章作成(約24%)です。従来のWeb検索に近い性格を持つのは、情報探索の部分だけです。
ブランドの可視性を測るプロンプトは、全体の中の薄い一枚のようです。
同じ意図でも、言い回しはほぼ重ならない
SparkToroとGumshoeの実験(2026年1月)では、142人が「ヘッドホンを買う」という同じ意図でプロンプトを書き、994件の回答が集まりました。文同士の意味的な類似度は、平均で0.081でした。Evertuneは、AIプロンプトの80%超が二度と同じ言い回しで聞かれない一意な文だとしています(Evertune FAQ)。
実プロンプトは、個人の事情を含みます。予算、家族構成、会社の規模、これまでの経緯です。複数ターンの会話の中で投げられます。公開コーパスのWildChat(約104万件の実会話、2023年4月から2024年5月)でも、会話は平均2.54ターン続いていました。
一方、市販の計測ツールはすべて、個人化されていない単発のプロンプトを投げて測ります。この構造的なずれは、どの流派の推測でも埋められていないようです。
実プロンプトは長く、文脈を含み、二度と同じ文では聞かれません。
推測の5流派
主要ツールの方法をたどると、プロンプトの作り方は次の5つに整理できます。
| 流派 | 出発点 | 強い点 | 弱い点 | 代表例 |
|---|---|---|---|---|
| キーワード変換型 | Googleのキーワード、関連質問、Search Consoleのクエリ | 再現性が高く、大量に作れる | 測っているのはGoogle側の需要で、言い回しと文脈は実物と違う | Ahrefs、Otterly.AI、PromptWatch |
| ペルソナ×ジャーニー合成型 | ペルソナ、購買段階、テーマの組み合わせ | 買い手のシナリオを網羅できる | 各場面の頻度は設計者の仮定で、「だれも聞かない質問」を量産しうる | Profound、Peec AI |
| 実ログ型 | 実際の会話ログの分類と集計 | 言い回しと文脈を直接観測できる唯一の系統 | 外部に出るのは集計値か、偏った古い標本だけ | OpenAI/NBER、Anthropic、WildChat |
| パネル観測型 | 同意した利用者パネルの実プロンプト | 実物を観測し、偏りを補正して投影できる | パネルの中身を外部から検証できない | Profound、Evertune、Similarweb |
| 一次データ接地型 | 自社の問い合わせ、営業、サポートの記録 | 自社の買い手の言葉そのものを使える | 既存顧客に偏り、規模が小さい | AthenaHQの手法、実務家の標準手順 |
5つの流派は、元になる基礎データ(キーワード、質問文、顧客の言葉など)が違います。基礎データが違えば、数字の意味も違います。
キーワード変換型
出発点は、数えられるものです。検索データです。Googleのキーワードや「他の人はこちらも質問」(People Also Ask)の質問群、Search Consoleの実クエリを、自然な質問文に書き換えてプロンプトにします。
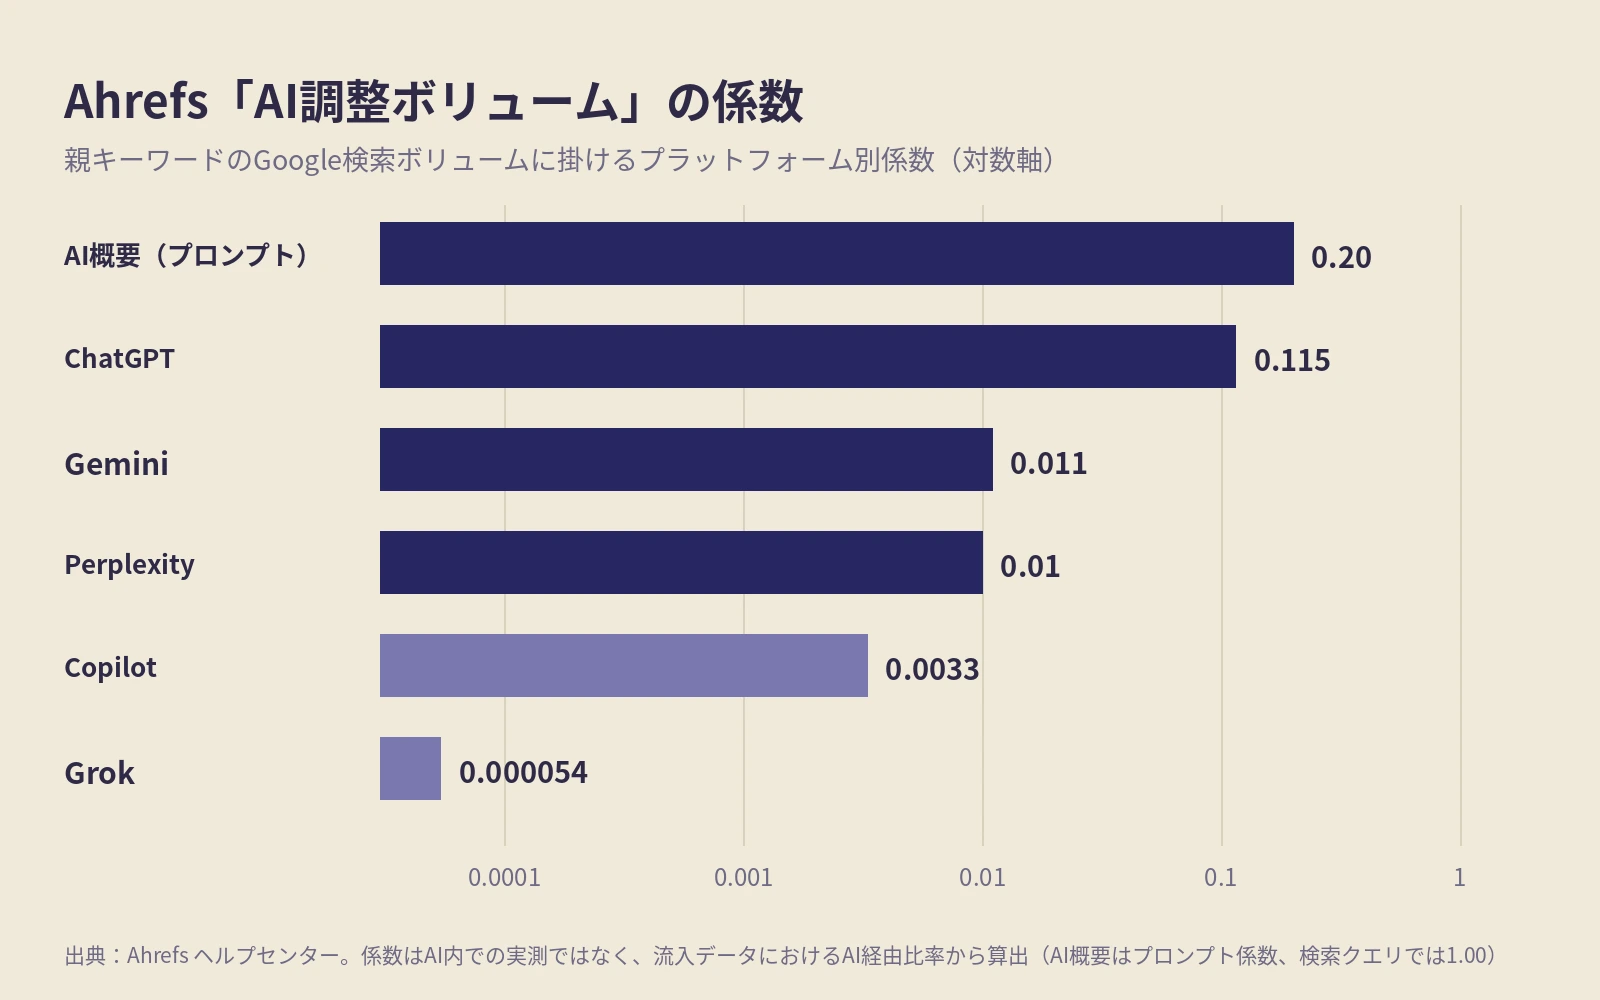
最も式を公開しているのはAhrefsです。同社の「AI調整ボリューム」は、親キーワードのGoogle検索ボリュームに、プラットフォームごとの係数を掛けて求めます。係数は、ChatGPTが0.115、GoogleのAI概要(プロンプト)が0.20(検索クエリでは1.00)、Geminiが0.011、Perplexityが0.01などと公表されています。これはBrand Radarの「AI調整ボリューム」の係数です。親キーワードの検索数が1,296件なら、ChatGPTでの想定値は約150件になります(Ahrefs ヘルプセンター)。
係数の出どころに注意してください。係数はAI内での計測ではありません。Ahrefsが集計するサイト流入データにおける、AIプラットフォーム経由の比率から求められています。
Peec AIが示す1から5の「プロンプトボリューム」も、実態は検索トレンドとキーワードの重みから作る相対スコアです(Peec AI ドキュメント)。「AIのボリューム」と表示されていても、中身が検索由来のことがある、という好例です。
PromptWatch もこの型です。Prompt Explorer が、Search Console のクエリ、ランキングキーワード、「People Also Ask」からプロンプト候補を提案します。同社の特徴は、回答の取得を API だけでなく実際の利用者画面から行うことと、モデル・国・言語といった計測条件を利用者が選べることです。同社の「Prompt Volumes」は、プロンプトに付随するキーワードについて Google・Bing・AI検索のボリュームを取り、AI検索を最も重く加重平均した推定で、1〜5段階の帯で表示されます(PromptWatch 公式の機能ページ)。パネル観測に基づく数字ではありません。
この流派の強みは2つです。基礎データが実在する需要であること。計算が再現できることです。弱みは、測っているのがGoogle側の需要だという点です。文脈を含む長い質問文や、検索に現れない用途は構造的に漏れるようです。
基礎データは実在します。ただし、それはGoogle側の需要です。
ペルソナ×ジャーニー合成型
ペルソナ(買い手の像)、購買の段階、テーマやユースケースを組み合わせ、質問文を合成する流派です。
ProfoundのAEOガイドは、実務家の枠組みであるPSUC(ペルソナ×セグメント×ユースケース)を引用しています。計測用プロンプトは実際の入力と一言一句一致しなくてよい、属性ごとのカバーこそが重要だ、という立場です。同ガイドが紹介するOGMチームの実験では、カテゴリを表す単語だけを4種に差し替えたところ(8プラットフォーム、14日間)、ブランドの可視性が25〜50ポイント動きました。反復回数と検索条件はガイドに開示されていません(Profound AEOガイド)。
Peec AIの自動生成では、指名キーワードを含む質問が20%です。インテントの配分は、情報収集25%・商用50%・取引25%が初期設定になっています(Peec AI ドキュメント)。
弱みは、組み合わせの各場面にどれだけの需要があるかが、設計者の仮定だという点です。生成AIに質問を作らせると、もっともらしいのにだれも聞かない質問をいくらでも作れてしまう、という批判があります(KampaignLab)。
実ログ型
実際の会話ログを分類し、分布を読む系統です。言い回し、文脈、複数ターンという実プロンプトの性質を直接観測できるのは、この流派だけです。
ただし、現在のログを丸ごと持っているのはプラットフォーム自身だけです。外部に出てくるのは集計値です。OpenAIの分析(NBER ワーキングペーパー)でも、個別のプロンプトやカテゴリ別の件数は公開されていません。AnthropicのClioは、プライバシーを保ったまま会話を要約し、分類して集計する仕組みです。Claudeではコーディング用途が大きな比重を占めるなど、分布がプラットフォームごとに違うことを示しました。
研究用に公開された実コーパスもあります。WildChat(約104万件)、LMSYS-Chat-1M(約100万件)、ShareGPT(約9万件)です。ただし標本には偏りがあります。無料利用と引き換えにログ提供へ同意した利用者、モデルを評価しに来た利用者、自分から面白い会話を共有した利用者です。時期も2023年から2024年が中心です。検索機能やメモリ機能を持つ現在の消費者向けアプリの姿とはずれているようです。言い回しの参考にはなっても、カテゴリごとの需要の重みには使いにくいと考えられます。
パネル観測型
発想は、テレビの視聴率調査に近いものです。同意した利用者パネルの実際のプロンプトを観測し、偏りを補正して全体へ投影します。
Profoundの「Prompt Volumes」は、二重の同意を得た消費者パネルから月間数千万件の実プロンプトを受け取ると説明しています。人口構成と地域の偏りを、確率モデルで補正している、という説明です。合成データは使っていない、という点も明記されています(Profound Prompt Volumes FAQ)。Evertuneは、人口構成で重み付けした1億5,000万件超の実会話からなる独自パネル「EverPanel」から、計測用プロンプトを取り出しているとしています(Evertune FAQ)。Similarwebも、同意した利用者のパネルなどから得た実際の利用者クエリを、匿名化・正規化して使うと説明しています(Similarweb 公式)。
Semrushは混成型です。クリックストリームとキーワードデータを組み合わせています。同社はプロンプト単位のボリュームは測りません。意味の近い質問を束ねたトピック単位で推定します。自社の数字は正確な数値ではなく、方向性を示す信号だ、と明記しています(Semrush ナレッジベース)。
この流派の弱みは、検証のしようがない点です。パネルの提供元、規模、国ごとの内訳は公開されません。購入者は中身を確かめられません。パネル自体が差し替わると、時系列が切れることもあります。SparkToroのゼロクリック調査(2024年と2026年の比較)では、データ提供元がDatosからSimilarwebへ替わっており、過去の数字と単純に比較できなくなりました。
この流派の本命は Profound です。同社はこの領域で最も多くの資金を集めた会社でもあります(AI検索最適化スタートアップの資金調達を追うValue Add VCの集計)。2026年9月のシリーズD(1億8,000万ドル)までで累計3億3,500万ドル超を調達し、評価額は18億ドルに達しました。実プロンプトを観測すると公言する、最有力の候補です。
ただし、壁が2つあります。第一に、Prompt Volumes はエンタープライズ契約でのみ提供されます(2025年6月にエンタープライズ向けの一般提供を開始)。実プロンプトに最も近いデータが、最も高い契約の内側にあります。第二に、バイアスです。パネル参加者は一般に、ポイントなどのインセンティブと引き換えにデータ提供へ同意した人々です。自社の本当の顧客が進んで入るものではないので、集まる層は構造的にインセンティブで動く人々へ寄ります。偏りは確率モデルで補正すると説明されますが、元になる標本の素性は公開されず、補正が効いているかは外からは確かめられません。
一次データ接地型
基礎データを、市場の推測ではなく自社の一次データに求める系統です。
AthenaHQが提示する実務手法は、買い手がすでに発している質問から最初のプロンプト集を作ります。顧客インタビュー、営業で受ける反論と評価の質問、サイト内検索のテーマ、サポートへの問い合わせです。 実務家のあいだでは、観測できた質問(Observed)と合成した質問(Synthetic)のリストを分けて管理する運用も提案されています。合成側は、実世界の裏付けが取れたものだけを観測側へ移す、という運用です(KampaignLab)。なお、自社サイトへのAI経由の流入データと突き合わせてプロンプト集を検証する、という考え方自体は、後述するマイクロソフトの公式開示(グラウンディングクエリ)で一部が実現しています。
弱みは2つです。集まる言葉が既存顧客に偏ること。規模が小さいことです。市場全体の需要を測る物差しにはなりません。
「プロンプトボリューム」は実測ではない
各ツールが示すプロンプトの需要量には、作り方が少なくとも4通りあります。一つ目はパネル観測からの投影、二つ目はクリックストリームをトピックに束ねたモデル、三つ目はGoogleの検索数への係数掛け、四つ目は計算方法が非公開の相対スコアです。同じ「ボリューム」という言葉でも、単位も意味もそろっていません。
こうした手法への批判的見方は、ほぼ一致しています。こうした数字は実測ではありません。別のデータから計算で作った推定値です。同じツールの中での割合の比較と推移の方向を見る用途には耐えます。ただし、絶対値としての需要量、ツール同士の比較、Googleの検索数への単純な加算、収益予測への入力には使えません(SEOBaz、2026年10月)。単位、プラットフォーム、期間、地域の4条件がそろわない数字は、比較の対象にならないという指摘もあります(Kairosy)。
共有インデックス型の数字には、もう1つの注意点があります。競合であるPeec AIの指摘では、Semrushのグローバルインデックスで、無関係な業界のブランドの可視性が同じ時期にそろって下がる動きが見られました。Google.comへの言及が3か月で700%増える動きもありました。データベースや標本の変更が、市場のトレンドであるかのように表示されることがあります(Peec AI による比較記事。競合他社による指摘であり、割り引いて読む必要があります)。共有インデックスのスコアは、自社の動きとインデックス自体の作りの変化を分けて読めないようです。
当社でも、混入を確認したことがあります。当社の AI Pulse が計測のために投げたプロンプトと同一の文面が、Ahrefs 側のデータに現れました(当社の運用上の確認です)。計測ツールは大量のプロンプトを日々実行します。その実行がパネルやクリックストリームに記録されれば、別のツールの「需要」の一部になります。測る側の活動が、測られるデータに混ざるわけです。
「ボリューム」は実測ではなく、別のデータから計算で作った推定値です。使えるのは、同じツールの中の割合と推移だけです。
ベンダー自身の注意書きも、同じ方向です。Semrushは「正確な数値はどのプラットフォームにも出せない」としています。Ahrefsは自社の数字を「方向性を示す指標」と位置づけています。
引用を決めるのは、利用者が打った文とは限らない
もう1つ、推測の前提を崩す仕組みがあります。クエリ・ファンアウト(query fan-out)です。
「クエリ・ファンアウト」は、Googleが2025年3月に公表した呼び名です。GoogleのAIモードは、利用者の質問を、サブトピックに沿った複数の関連検索へ裏側で展開し、回答を組み立てます(Google、2025年3月5日)。ただし、質問を裏側で複数の検索に分解する仕組み自体は、Googleに限ったものではありません。検索を使うAIに共通する動きで、ChatGPTやCopilotでも同じことが起きています(ChatGPTの裏側検索の推計と、Copilotのグラウンディングクエリは後述します)。ページが引用されるのは、利用者が打った文に合ったからとは限りません。裏側で生成されたサブクエリのどれかに合ったから、ということが起きているようです。Nectivが自社のAI Trackerで8,500件超の商用プロンプトを分析した一次調査では、検索が発生したのは31%で、裏側検索の数は平均2.17件、最大4件でした(Nectiv の調査)。
この裏側のサブクエリは、原則として外から見えません。例外はマイクロソフトです。Bingウェブマスターツールの「AIパフォーマンス」(2026年2月公開)と Microsoft Clarity は、自社サイトが引用された場面について、裏側の検索クエリ(グラウンディングクエリ)の一部をサイト所有者に開示します。対象はCopilotなどマイクロソフト系のAIで、データはサンプルですが、ファンアウトの実物が見える数少ない公式の窓です。
回答そのものも、毎回同じではありません。SparkToroとGumshoeは、ボランティア600人に同じ12件のプロンプトを3つのAIツールで実行させ、2,961件の回答を集めました(既定設定、2025年11〜12月収集、査読なし)。ブランドの顔ぶれが完全に一致した回は1%未満でした。順序まで一致した回は0.1%未満でした。なお、別の集計(前述のヘッドホン購入プロンプト994回答)では、主要ブランドの「言及される頻度」は55〜77%の範囲でした。顔ぶれは毎回変わるのに、大手の言及頻度だけは比較的安定する、という構図です(SparkToro/Gumshoe、2026年1月)。
Evertuneはこの揺れを前提に、各プロンプトをモデルごとに100回実行する方式を取っています。同社の反復実験(ChatGPTのみ、ランニングシューズの10トピック×10プロンプトを各100回、計1万回答)では、トピック単位の誤差は1回だけの計測で最大±31ポイント、100回の反復で最大±3ポイントまで縮みました。ただし、これはトピック単位で平均した誤差です。プロンプト単位では、100回の反復でも±10ポイント以内の誤差が残りました(Evertune の実験記事)。なお同社のFAQでは、100回の反復で誤差は全体で約1ポイント、トピック単位で約2ポイントと説明されています。
プロンプトの推測と同じくらい、反復の設計が数字の信頼性を左右します。
当社の計測で見えたこと:言い回しが数字を決める
ここからは、当社の一次データです。対象は、当社のAI可視性モニタリング基盤(AI Pulse)に蓄積された会話データです。LLMO/AIO/GEOをテーマとする非指名の質問23種を、29の取得経路で日次反復計測した記録から、2026年5月12日から11月6日に取得した11,160件を集計しました。質問文に自社名を含むものは含まれていません。言及の判定は、回答文からブランド名を抽出する当社の処理(抽出モデルはGemini 2.5 Flash-Lite)によります。なお、検索機能のオン・オフは会話単位では記録しておらず、回答モデルも提供側の都合で期間中に変わっているため、固定はされていません。開示が足りない点も含め、当社の計測条件はこの通りです。
ガーオンへの言及があったのは215件でした。全体の1.9%です。
言及率は、質問の言い回しで大きく動きました。「PR会社」という枠組みの質問(2つの質問文、151件)では、63.6%(96件)の会話でガーオンへの言及がありました。「コンサル会社」という枠組みの質問(「LLMO対策ができるコンサル会社のおすすめは?」という単一の質問文の反復、1,960件)では、言及は0件でした。聞き方を1つ変えるだけで、同じ会社の可視性は6割にも0にもなります。
経路でも差が出ました。実際のWeb画面から取得したブラウザ経由の会話(1,355件)では言及率が12.7%でした。APIなどその他の経路の会話(9,805件)では0.44%でした。言及があった会話の89.3%(215件中192件)では、gaaaon.jpのページが引用元に含まれていました。逆向きに数えると、gaaaon.jpが引用された会話(224件)のうち言及があったのは85.7%です。
計測用プロンプトは「顧客の声の再現」である前に、数字を作る設計そのものです。
ここまでが事実です。ここからは当社の解釈になります。
当社は、5流派のうち「一次データ接地型」を土台にするのが現実解だと読んでいます。理由は2つです。日本語の実プロンプトについて、公開された観測データは今回の調査では見つかりませんでした。土台にできる実データが市場にない以上、自社の買い手の言葉を基礎データにするしかありません。そのうえで、合成で不足分を補い、反復計測で頻度を読みます。
明日からできる5つのアクション
- プロンプトセットを設計物として扱ってください。どの流派で作ったか、基礎データは何か、配分はどう決めたかを、数字と一緒に残してください
- 基礎データは一次データから作ってください。問い合わせ、営業、サポート、サイト内検索に出てきた質問が出発点です。観測できた質問と合成した質問は、分けて管理してください
- 数字は「同じツールの中の割合と推移」で読んでください。ボリュームの絶対値や、ツール同士の比較、収益の試算に使わないでください。回答の中の順位は実行のたびに入れ替わります。追うべきは、言及される割合(言及率)と、第一推奨に選ばれているかです
- 言い回しのバリエーションを広く持ってください。結果は反復して頻度で読んでください。1プロンプト1回の「出た・出ない」で判断しないでください。必要な反復回数は、求める精度と、読む単位から逆算します。Evertune の反復実験(ChatGPT、ランニングシューズ)では、トピック単位の誤差は1回の計測で最大±31ポイントあり、100回の反復で最大±3ポイントまで縮みました。ただし、これは多数のプロンプトをトピック単位で平均した誤差です。プロンプト単位で言及率を読む場合、100回の反復でも信頼区間は最大で±10ポイント程度あります(300回で約±6ポイント、±3ポイントまで絞るには1,000回規模が要ります)。数回だけの実行では、数十ポイントの誤差がある前提で数字を読むしかありません。結局のところ、必要な精度は、競合との言及率の差をどこまで読みたいかで決まります。自社が1強で競合と大きく離れている局面では粗い数字でも判断できますが、競合と競り合う局面では、差が誤差の中に埋もれないだけのサンプルが要ります。当社では、誤差を約±6ポイントまで抑える目安として、300サンプルを推奨しています(±5ポイントまで絞るには約400サンプルが必要です)(関連記事:LLMO計測はプロンプトで決まる)
- ファンアウトを前提に情報を用意してください。表面のプロンプトだけでなく、裏側のサブクエリに当たりうる一次情報、比較表、FAQを用意してください
プロンプトの作り方を開示できないツールの数字は、その時点で割り引いて読むのが安全です。「実プロンプトに基づく」という説明だけでは、パネルなのか、合成なのか、検索由来なのかを区別できません。
よくある質問
プロンプトボリュームの数字は、どこまで信用できますか
同じツールの中での割合の比較と、推移の方向を見る範囲では使えます。絶対値としての需要量、ツール同士の比較、収益予測への入力には使えません。作り方が会社ごとに違い、単位も意味もそろっていないためです。
自社で計測用プロンプトを作るには、何から始めますか
一次データから始めてください。問い合わせ、営業、サポート、サイト内検索に、買い手の質問がすでに出ています。合成は不足分の補完に回し、観測できた質問とは分けて管理してください。
日本語の実プロンプトの観測データはありますか
公開された観測データは、今回の調査では見つかりませんでした。海外のパネルやコーパスは英語中心です。日本語の実プロンプトはとくに見えにくい領域です。
まとめ
たった1行で言えば、顧客の質問は見えないので、計測の信頼性は「推測の作り方を開示できるか」で決まります。
実プロンプトは検索キーワードより長く、文脈を含み、言い回しがほぼ重なりません。その大半は仕事以外の用途です。「プロンプトボリューム」は実測ではなく、別のデータから計算で作った推定値です。当社の計測でも、言い回し1つで可視性は0%にも6割にも動きました。
見えないものを、どの推測で近づけるか。その方法の選択と開示が、AI検索計測の信頼性を決めます。
当社の計測データからは、もう1つ読み取れることがあります。AIに自社ページを引用されることと、自社の名前を挙げてもらうことは、別の問題だということです。ガーオンのページが引用された会話では、85.7%で社の名前も挙がっていました。引用まで届けば、名前はほぼ付いてきます。大きく振れたのは、その手前です。質問の言い回しが変わると、名前が挙がる割合は0%から63.6%まで動きました。対策の中心は、引用されるページを増やすことだけではありません。買い手がどの言い回しで聞いたときに想起されるか、その言い回しの設計にあります。
この構図は、最新の公式動向でも変わりません。2026年11月10日にOpenAIが公開した企業向け「Businesses in ChatGPT」の「Brand Insights」で見られるのは、言及回数やプロフィール閲覧数、サイトへのクリック数といった集計だけです。プラットフォーム自身の公式画面でも、利用者が入力した質問文そのものは出てきません。
再現性を決めるのは、プロンプトだけではありません。モデル名(バージョンを含む)、地域、ペルソナ設定(システムプロンプト)が違えば、同じプロンプトでも回答は変わります。これらの設定がどうなっているか確認できない計測は、再現性がありません。設定を明示していない数字は採用を控え、設定を確認できる環境のツールを選びましょう。
AI Pulseは、株式会社ガーオンのAI可視性モニタリングサービスです。生成AIとGoogleのAI検索面を、条件を固定して継続的に計測します。プロンプトの設計方法も含め、AI検索での見え方にお悩みの方はお気軽にご相談ください。
関連記事:マシンリレーションズ入門、LLMO計測はプロンプトで決まる
参考文献・参考リンク
ツール公式の方法論
- Otterly.AI ヘルプセンター「How to find relevant prompts for your brand?」:AI検索エンジンがクエリデータを公開していないこと、キーワードやSearch Consoleクエリからの変換方法
- Ahrefs ヘルプセンター「What is AI adjusted volume and how is it calculated」:AI調整ボリュームの計算式とプラットフォーム係数。方法論の一次資料は同社ブログ「Brand Radar methodology」(「方向性を示す指標」という位置づけと、Google検索数との検証済みの関係はない旨の明記)
- PromptWatch「AI Agent Instructions」(2026年11月3日更新):Prompt Explorer の候補生成(Search Console、キーワード、People Also Ask)、実UIからの回答取得、モデル・国・言語の選択、MCP/API の提供。Prompt Volumes の算出方法は同社「機能ページのFAQ」(付随キーワードの Google・Bing・AI検索ボリュームの加重平均)
- Profound「AEO Guide Chapter 3: Promptologie」:PSUCの枠組みとプロンプトの類型
- Profound「Prompt Volumes FAQ」:二重同意パネルと確率モデルによる補正
- Peec AI ドキュメント「Setting up your prompts」:自動生成の初期配分と、検索由来のボリュームスコア
- Profound 公式ブログ「Series D」(2026年9月15日):シリーズD 1億8,000万ドル、評価額18億ドル、累計3億3,500万ドル超
- Profound 公式ブログ「Announcing general availability of Prompt Volumes」(2025年6月10日):Prompt Volumes のエンタープライズ向け一般提供と、パネル観測+確率モデルの説明
- Evertune「GEO & AI Search FAQ」:EverPanelと、100回の反復での誤差(全体約1ポイント、トピック約2ポイント)。反復実験の原典は「Repeated sampling enables GEO action by topic and prompt」(ChatGPT、ランニングシューズ、1万回答)
- Semrush ナレッジベース「Where does the data in Semrush's AI Visibility Toolkit come from?」:クリックストリームとキーワードの混成、トピック単位の推定
研究・実データ
- Chatterji et al.「How People Use ChatGPT」(NBER Working Paper 34255、2025年9月):ChatGPT利用実態の内訳
- Anthropic「Clio: Privacy-preserving insights into real-world AI use」:プライバシー保護型の会話分析
- Zhao et al.「WildChat」、Zheng et al.「LMSYS-Chat-1M」:公開実コーパスの規模と偏り
- Google「Expanding AI Overviews and introducing AI Mode」(2025年3月5日):クエリ・ファンアウトの説明
- Nectiv「New Data Study: What Queries Is ChatGPT Using Behind the Scenes?」:自社AI Trackerによる一次調査(8,500件超、検索発生31%、裏側検索は平均2.17件・最大4件)
- Similarweb「Data for AI」と「Top AEO Tools」:オプトインした利用者パネルと、匿名化・正規化した実利用者クエリの説明
- Semrush 2025年版調査の数値(4分類で約70%が unknown、2024年7〜12月・8,000万行超)は、原典ページが現行版に書き換えられているため、要約「Do ChatGPT Queries Average 23 Words Compared With 4 for Google?」(Kovmere)による
- Microsoft「Introducing AI Performance in Bing Webmaster Tools」(2026年2月10日、パブリックプレビュー):自社サイトの引用数とグラウンディングクエリの開示。Microsoft Clarity「Citations in Microsoft Clarity Now Generally Available」(2026年5月一般提供)も同種の開示を行う
- SparkToro/Gumshoe「New Research: AIs Are Highly Inconsistent When Recommending Brands or Products」(2026年1月28日):AI推奨のばらつき実験(2,961回答の本実験と、ヘッドホン994回答の言及頻度55〜77%は別集計)
- OpenAI「Introducing Businesses in ChatGPT」(2026年11月10日):Business Hub と Brand Insights のベータ公開。出すのは言及・閲覧・クリック・テーマの集計のみで、実プロンプトは含まれない。Search Engine Roundtable「ChatGPT Business Hub」も同内容を報道
批判と論点
- SEOBaz「Is AI Search Volume Data Reliable?」(2026年10月)、Kairosy「Prompt Volume Data Explained」:ボリューム推定への批判
- KampaignLab「Question Research for AI Search」:Observed と Synthetic の分離